Llevo tres años cambiando de hardware homelab y cometiendo los mismos errores que todos al principio. Empecé con una Raspberry Pi, di el salto a un PC viejo de torre, y después de varios recorridos y facturas de luz más altas de lo que me esperaba, llegué a los mini PCs. Hoy mi homelab principal corre sobre un Minisforum MS-01 y un par de nodos más pequeños, y estoy razonablemente contento.
Este no es un post de teoría sobre IA. Es lo que realmente tengo montado, lo que ha funcionado, lo que no, y por qué creo que la forma en que muchas empresas están aproximándose a los agentes de IA está mal planteada.
Contexto: gestiono la distribución de varias marcas de cosmética de lujo en España. Marcas con catálogos grandes (cientos de productos), terminología muy específica (ingredientes activos, protocolos de tratamiento, formaciones de terapeuta), y materiales que constantemente hay que adaptar: manuales, fichas de producto, presentaciones para clientes, contenido para redes sociales.
Antes de Uptime Kuma, mi sistema de monitorización consistía en abrir el navegador, escribir la IP de cada servicio y ver si respondía. Funciona, pero está lejos de ser un sistema. Un día me enteré de que un servicio llevaba 14 horas caído porque nadie (yo incluido) lo había comprobado manualmente en ese tiempo.
Eso fue hace dos años. Desde entonces tengo Uptime Kuma corriendo en el homelab y me avisa antes de que yo me dé cuenta de que algo falla. Con cuarenta y tantos monitores configurados, es el servicio que más uso en el día a día aunque sea el que menos veo, precisamente porque cuando funciona bien no necesita atención.
Perdí tres meses de trabajo una vez. No en un homelab, en un servidor de producción, pero la lección se me quedó grabada. Desde entonces tengo una regla no negociable: si no hay backup verificado, no existe.
Durante mucho tiempo usé las snapshots de Proxmox como backup. Es cómodo y rápido, pero es una trampa. Las snapshots viven en el mismo almacenamiento que las VMs. Si falla el disco, pierdes las VMs y las snapshots de golpe. Eso no es un backup, es una ilusión de seguridad.
Durante mucho tiempo pensé que los racks de 19 pulgadas eran la única solución seria para organizar un homelab. Luego miré los precios. Un rack de pared de 6U de marca decente ronda los 80-120 euros, los panels ciegos son absurdamente caros para lo que son, y los soportes específicos para mini PCs o SBCs te los inventas tú porque nadie los fabrica.
O te los imprimes.
Hace dos años tenía mi homelab montado en dos estantes de madera de Ikea. Los Minisforum apilados con separadores de goma. Los ZimaBoard colgando de sus propios cables. Un Switch TP-Link en equilibrio sobre lo que pillase. Funcionaba, pero era un desastre visual y también práctico, porque cuando tenía que revisar algo físicamente perdía cinco minutos identificando qué cable iba a qué máquina.
Si llevas tiempo con el homelab, en algún momento llegaste al punto donde tienes cinco o seis servicios corriendo y necesitas acceder a todos por nombre de dominio en vez de por IP y puerto. Ahí es donde entra el reverse proxy.
Los dos más populares son Nginx Proxy Manager y Traefik. Los he usado los dos en producción, en momentos distintos de la vida de mi homelab, y tengo opiniones formadas sobre cuándo usar cada uno.
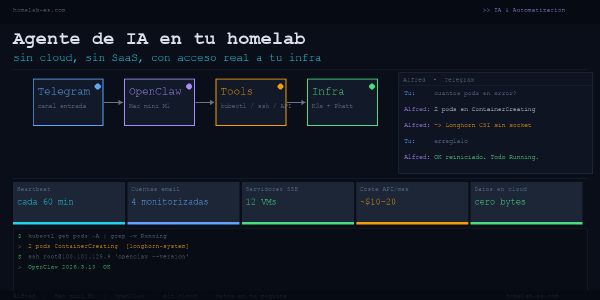
Un agente de IA que monitoriza tu infraestructura, revisa el email y ejecuta comandos en tu clúster K3s. Sin SaaS, sin datos que salen de tu red. Esto es lo que monté y lo que aprendí tras meses usándolo.
Tengo un Mac mini que uso como servidor principal. Está siempre encendido. Pero también tengo tres ZimaBoards que forman parte de mi cluster K3s. Esas máquinas consumen poco (10W cada una), pero cuando no las necesito, las apago. El problema: cuando las necesito, están en otro cuarto.
Podría levantarme, ir al cuarto, pulsar el botón de encendido. O podría enviar un paquete mágico por la red que las despierta automáticamente. Segundo escenario, por favor.
Llevo casi dos años con Home Assistant corriendo en mi homelab y es una de las cosas que más uso cada día. No es la instalación más compleja que tengo (ese premio se lo lleva el cluster de Kubernetes), pero es la que más impacto tiene en mi vida diaria.
La diferencia entre tener cacharros “inteligentes” sueltos por casa y tener Home Assistant es brutal. Pasas de 47 apps diferentes que medio funcionan a tener todo en un solo sitio. Y lo mejor: cuando Philips o Samsung decidan que tu bombilla o tu enchufe “ya no son compatibles”, te da igual. Home Assistant seguirá funcionando.
Voy a empezar por el final: perdí datos. No una vez, dos veces.
Primera vez, 2022: un disco del NAS palmó. Pensaba que RAID 1 era backup. No lo es. Perdí 6 meses de fotos familiares porque el segundo disco falló 48 horas después del primero (RAID failure correlacionado, mismo lote de discos).
Segunda vez, 2024: actualización de Proxmox que se fue al carajo. Recreé las VMs desde cero, pero perdí configuraciones de servicios que no había documentado. 3 días de trabajo para volver a tener todo funcionando.
Tengo 47 dispositivos conectados a mi red. Entre servidores, móviles, tablets, bombillas Hue, enchufes inteligentes, impresoras, la TV… es un caos. Y hasta hace un mes, todos estaban en la misma red. Todos podían verse entre sí.
Eso incluye la bombilla del salón pudiendo hablar con mi Synology donde guardo contratos y documentos fiscales. No es que la bombilla vaya a hackearme, pero el firmware lo fabrica una empresa china que nunca ha oído hablar de actualizaciones de seguridad.
Llevo dos años pagando GitHub Pro. 4$ al mes. No es mucho dinero pero me molestaba. No porque sea caro, sino porque estaba pagando por algo que podía tener en mi homelab. Repos privados ilimitados, CI/CD, wikis, issues… todo corriendo en 200MB de RAM.
En diciembre monté Gitea y migré todos mis repos. No he vuelto a GitHub para proyectos personales.
Por qué self-hostear Git # GitHub está bien. Es rápido, fiable, todo el mundo lo conoce. Pero tiene varios problemas si trabajas en proyectos personales o internos de empresa: