Durante años fui usuario de Plex. Lo consideraba la solución definitiva para tener mi biblioteca de películas y series accesible desde cualquier dispositivo. Luego llegaron los cambios en las condiciones del servicio, la cuenta online obligatoria para acceder a tu propio servidor en red local, y la dirección cada vez más claramente orientada a convertirlo en otra plataforma de contenido de pago.
No digo que Plex sea malo. Sigue siendo muy bueno en muchas cosas. Pero cuando empecé a investigar alternativas, encontré Jellyfin y me di cuenta de que no necesito Plex para lo que yo hago.
Este no es un post de teoría sobre IA. Es lo que realmente tengo montado, lo que ha funcionado, lo que no, y por qué creo que la forma en que muchas empresas están aproximándose a los agentes de IA está mal planteada.
Contexto: gestiono la distribución de varias marcas de cosmética de lujo en España. Marcas con catálogos grandes (cientos de productos), terminología muy específica (ingredientes activos, protocolos de tratamiento, formaciones de terapeuta), y materiales que constantemente hay que adaptar: manuales, fichas de producto, presentaciones para clientes, contenido para redes sociales.
Perdí tres meses de trabajo una vez. No en un homelab, en un servidor de producción, pero la lección se me quedó grabada. Desde entonces tengo una regla no negociable: si no hay backup verificado, no existe.
Durante mucho tiempo usé las snapshots de Proxmox como backup. Es cómodo y rápido, pero es una trampa. Las snapshots viven en el mismo almacenamiento que las VMs. Si falla el disco, pierdes las VMs y las snapshots de golpe. Eso no es un backup, es una ilusión de seguridad.
Si llevas tiempo con el homelab, en algún momento llegaste al punto donde tienes cinco o seis servicios corriendo y necesitas acceder a todos por nombre de dominio en vez de por IP y puerto. Ahí es donde entra el reverse proxy.
Los dos más populares son Nginx Proxy Manager y Traefik. Los he usado los dos en producción, en momentos distintos de la vida de mi homelab, y tengo opiniones formadas sobre cuándo usar cada uno.
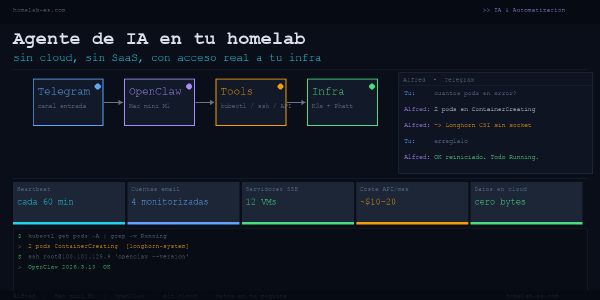
Un agente de IA que monitoriza tu infraestructura, revisa el email y ejecuta comandos en tu clúster K3s. Sin SaaS, sin datos que salen de tu red. Esto es lo que monté y lo que aprendí tras meses usándolo.
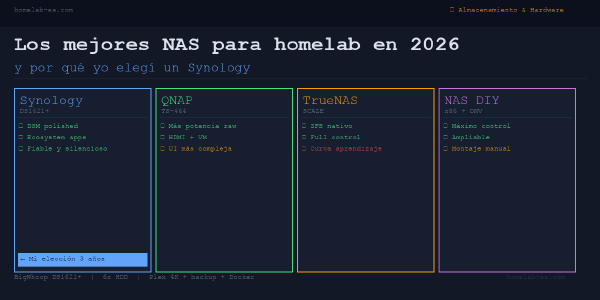
Llevo tres años con un Synology DS1621+ en producción. He considerado cambiarlo dos veces, y las dos veces decidí quedarme. Aquí está todo lo que aprendí sobre NAS para homelab.
Montar tu propio servidor de correo en casa es una de esas ideas que suenan increíbles a las dos de la mañana y bastante peores a las nueve de la mañana del día siguiente. Yo he estado en los dos estados mentales. Primero la ilusión de tener control total. Luego el baño de realidad cuando empiezas a pelearte con SPF, DKIM, DMARC, reputación IP, puertos bloqueados y filtros antispam que te miran con sospecha aunque no hayas hecho nada raro.
Llevo casi dos años con Home Assistant corriendo en mi homelab y es una de las cosas que más uso cada día. No es la instalación más compleja que tengo (ese premio se lo lleva el cluster de Kubernetes), pero es la que más impacto tiene en mi vida diaria.
La diferencia entre tener cacharros “inteligentes” sueltos por casa y tener Home Assistant es brutal. Pasas de 47 apps diferentes que medio funcionan a tener todo en un solo sitio. Y lo mejor: cuando Philips o Samsung decidan que tu bombilla o tu enchufe “ya no son compatibles”, te da igual. Home Assistant seguirá funcionando.
Voy a empezar por el final: perdí datos. No una vez, dos veces.
Primera vez, 2022: un disco del NAS palmó. Pensaba que RAID 1 era backup. No lo es. Perdí 6 meses de fotos familiares porque el segundo disco falló 48 horas después del primero (RAID failure correlacionado, mismo lote de discos).
Segunda vez, 2024: actualización de Proxmox que se fue al carajo. Recreé las VMs desde cero, pero perdí configuraciones de servicios que no había documentado. 3 días de trabajo para volver a tener todo funcionando.
Mi servidor Plex llevaba meses quejándose. Tres streams simultáneos y el pobre Xeon E3-1230v3 se ponía a 80% de CPU, el ventilador sonaba como un reactor nuclear y empezaban los tirones. Si alguien intentaba ver una película 4K, ni te cuento.
Sabía que la solución era transcodificación por hardware, pero tardé semanas en configurarlo bien. Internet está lleno de tutoriales que asumen que sabes lo que haces o que directamente no funcionan. Este post es lo que yo habría querido leer hace dos meses.
n8n es la herramienta de automatización que tenía que haber instalado antes. Sin código, self-hosted y con 400 integraciones. Aquí están los flujos que uso de verdad en mi homelab.
Tres ZimaBoard 2, una VPN mesh y ganas de sufrir. Así monté un clúster Kubernetes de producción que consume 20W y corre 34 pods. Tutorial paso a paso con todo lo que funcionó y lo que no.