Documentar un homelab no va de hacer una wiki preciosa. Va de poder arreglar algo cuando estás cansado, saber qué depende de qué y no descubrir demasiado tarde que nadie apuntó dónde vivían los datos.
Hay una clase de fallo que me parece bastante peor que un error claro. El fallo silencioso. El que no rompe con estruendo, no manda una alarma espectacular y no te deja un log rojo diciendo “esto ha salido mal”. Solo sigue adelante, aparenta normalidad y mientras tanto te está preparando una hostia para más tarde.
Eso fue exactamente lo que me obsesionó con mis backups por NFS. El problema no era que el backup remoto se cayera. Eso puede pasar. El problema era algo más traicionero. El montaje remoto no estaba donde debía, el script aún tenía un camino alternativo local, y la combinación de ambas cosas podía convertir una copia supuestamente segura en un proceso bastante eficiente llenando el disco del host.
Hay una fase bastante cutre en casi todo homelab con Proxmox. La de decirte a ti mismo que levantar una VM nueva son cinco minutos y luego echar media hora repitiendo siempre lo mismo. Crear la máquina, montar ISO o importar imagen, tocar red, meter clave SSH, actualizar paquetes, instalar cuatro utilidades, corregir alguna tontería del hostname y cruzar los dedos para no haber dejado un usuario raro o una configuración vieja de otra prueba. No es un drama, pero tampoco es serio.
Hay una cosa que me sigue haciendo gracia del mundo self-hosted. Montamos infra cada vez más compleja para acabar resolviendo tareas que, en el fondo, se arreglan con dos comandos bien puestos y un poco de criterio. Publicar una web estática es una de ellas.
He probado flujos más elaborados. CI/CD con más capas, builders remotos, pipelines con demasiadas piezas, deploys muy listos sobre el papel y algo menos listos cuando fallan a las dos de la mañana. Al final he vuelto a lo que mejor me funciona para proyectos pequeños y medianos que controlo yo: Hugo para generar el sitio y rsync para dejarlo en el servidor.
Tuve una historia de amor y odio con los backups durante años. Amor porque siempre tenía la intención de montarlo bien. Odio porque cada solución que intentaba tenía algo que me echaba atrás: demasiado complicada, demasiado lenta, imposible de verificar, o que dejaba de funcionar en silencio durante semanas sin que yo me enterara.
Rsync para hacer copias de directorios. Duplicati con su interfaz web que prometía mucho y entregaba poco. Borg Backup, que es técnicamente excelente pero que tiene una curva de aprendizaje suficientemente pronunciada como para que lo dejara a medias dos veces.
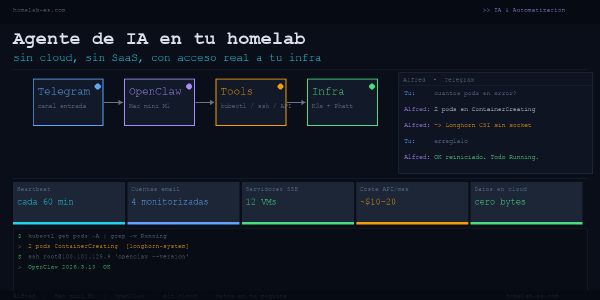
Un agente de IA que monitoriza tu infraestructura, revisa el email y ejecuta comandos en tu clúster K3s. Sin SaaS, sin datos que salen de tu red. Esto es lo que monté y lo que aprendí tras meses usándolo.